测试spine动画图片比较大,没有做合批,主要是提升渲染效率和在移动端降低电量消耗
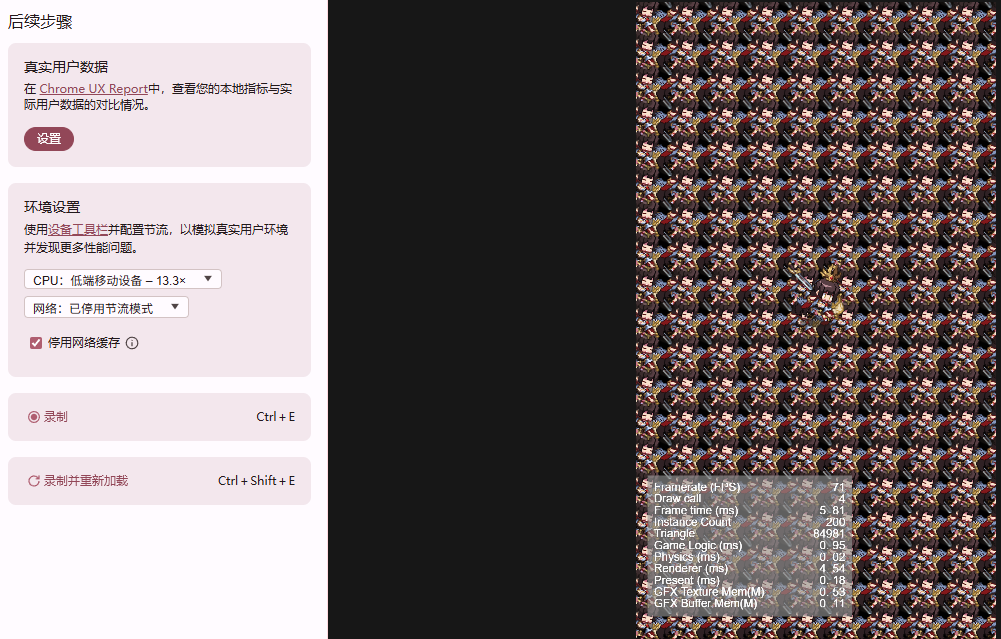
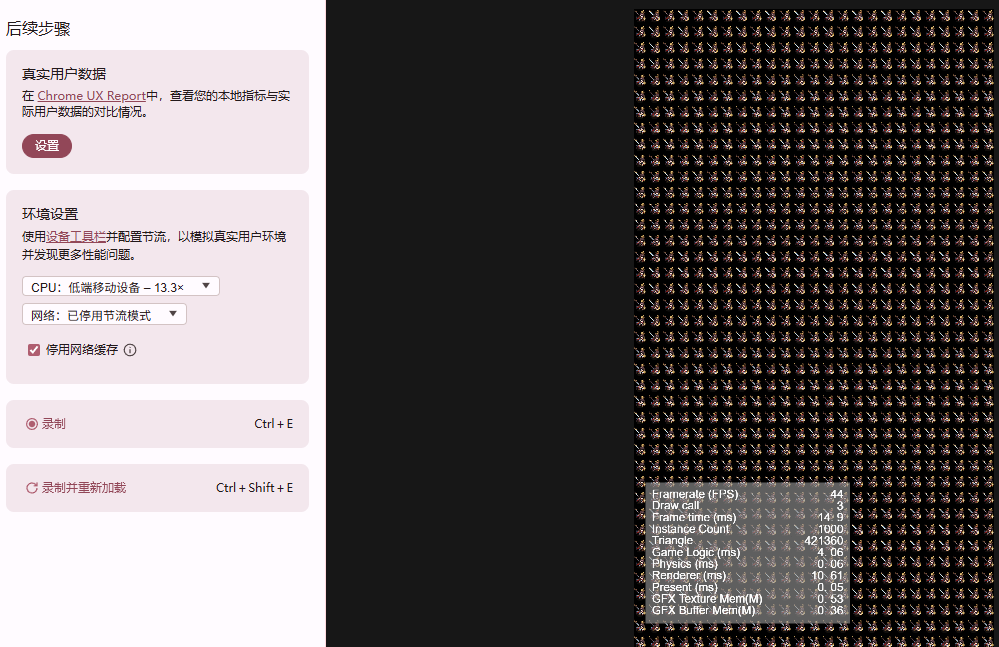
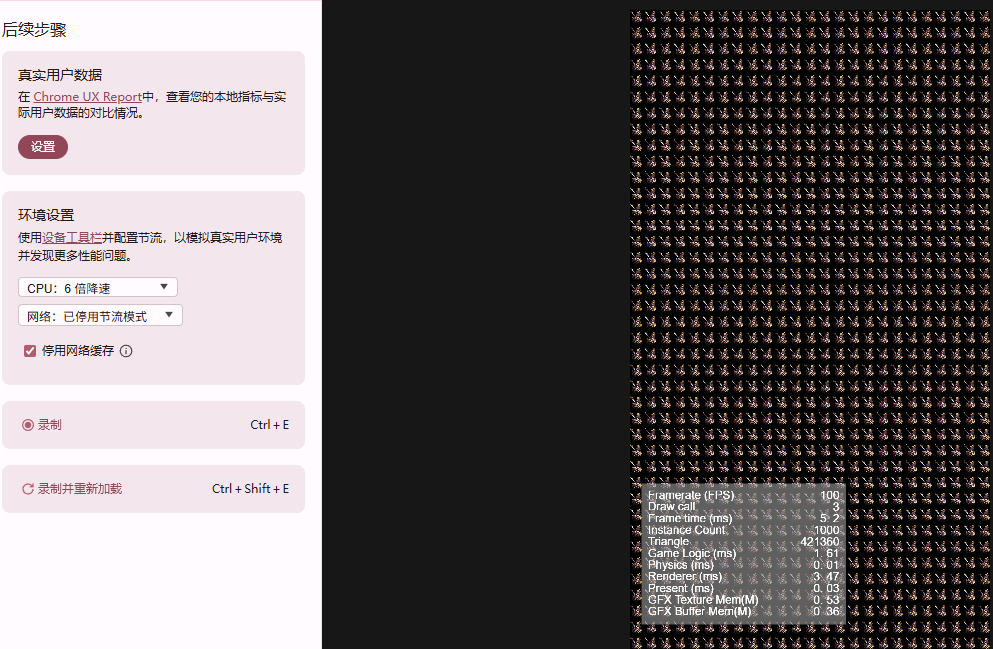
这就厉害了.
dc也降下来了.
开贴细说 
正在用ai整理成cocos拓展
1赞
gpt神力
动手能力真强,我最近没时间搞
 是的主要是理解思路,用AI很好复刻的
所以啥情况了?你这隐私设置的,毫无进展信息 
2.x 3.x都在里面
可以在你的帖子里加点思路上的内容吗?
包可以的 兄弟
看了下,好像只有运行实例。烘培工具没开源吧?我要用AI抄一个了,望批准 
有的兄弟 拓展我还没上传 这几天比较忙 今天会更新上去
1赞
我上传了 大佬 可以根据这个改 省点token

vat-spine.zip (1.0 MB)
根据俩帖子内容、案例、cocos 源码蒸馏后的知识库,可以自行下载参考(甚至作为 SKILL 给 Agent 使用)。
贴下 README 内容:
Spine 动画 GPU 化(VAT)示例
把 Cocos Creator 里"被动播放、不参与交互"的 Spine 动画,用 VAT(Vertex Animation Texture,顶点动画贴图) 把每帧顶点位置/UV/颜色烤进纹理,运行时在顶点着色器里采样还原,从而把骨骼计算与每帧顶点上传从 CPU 挪到 GPU。
这是 cocos-creator-game 工程下
ai-demos/vat-spine的示例,对应社区帖
Spine 动画 GPU 化实战:用 VAT 把骨骼计算挪出主线程。
帖子的想法我们照做,但它的结论(6.9× / 40×)我们用引擎源码做了复核与修正,见下方「与官方 cache 模式对比」。
一、背景与结论(已用 3.8.6 源码核实)
帖子主张:用 VAT 让 200 个 Spine 同屏,渲染耗时从 ~34ms 降到 ~5ms(6.9×),Draw Call 从 203 降到 5(40×)。
我们用 cocos-source-mcp 查了 cocos-engine-3.8.6,确认了两件事:
-
帖子的前提属实:官方
SHARED_CACHE/PRIVATE_CACHE模式虽然把骨骼解算结果缓存了,但顶点缓冲仍在 CPU 里,每帧assembler/simple.ts的cacheTraverse仍做vUint8Buf.set(model.vData)+ 顶点色循环 +setDirty(),等于每帧把缓存顶点 memcpy 并重新上传 GPU。VAT 确实能消掉这条路径。 -
帖子的对比基准有误导:官方的 cache 模式运行时已经不做骨骼解算(
skeleton.ts:1065-1095的 cache 路径只this._curFrame = frames[frameIdx],updateRenderData()直接返回_curFrame.model,零 wasm 调用)。所以帖子的 6.9× 是拿 VAT 跟 REALTIME 模式比的——而官方 cache 模式已经白送了最大头的 CPU 收益。VAT 相对官方 cache 的真正增量是:省掉每帧顶点 memcpy + 上传 + 顶点色打包,并打通 GPU 合批(1 个 Draw Call)。
一句话定调:VAT 在 3.8.6 能落地,但别拿帖子的 6.9× 当它的独占功劳——它是在官方 cache 之上再榨一层"上传 + 合批"的油。
二、原理
离线(bake):Spine 每帧顶点 ──┐
               Spine 每帧 UV  ──┼─> 烤进 3 张 RGBA8 数据图(行=帧,列=顶点)
               Spine 每帧颜色 ──┘
运行时(每帧):只改一个 frameIndex uniform
        └─> 顶点着色器按 (vatCol, frame) 采样 3 张图
              ├─ vatPos  → 解出世界坐标 xy
              ├─ vatUv   → 解出采样 atlas 的 uv
              └─ vatColor → 解出顶点色
        └─> 片元着色器用 uv 采样 atlas 贴图,乘以顶点色输出
CPU 每帧零骨骼解算、零顶点上传(基础网格是静态的,只建一次)。这也是它相对官方 cache 的增量收益来源。
与官方 cache 模式对比
| 维度 | REALTIME (sp.Skeleton) |
官方 SHARED/PRIVATE CACHE | 本示例 VAT |
|---|---|---|---|
| 运行时骨骼解算 | 每帧 wasm 解算 | 无(已烘焙) | 无(已烘焙) |
| 每帧顶点上传 GPU | 是 | 是(cacheTraverse memcpy+setDirty) |
否(静态网格) |
| 多实例合批 | 难 | 难(按 mesh/textureID 多 draw) | 可做 GPU Instancing → 1 Draw Call |
| 适合场景 | 主角/IK/换皮/挂点 | 固定动画、无换皮 | 装饰/背景等被动播放 |
| IK / 动态换 skin / socket |  |
 (warnID 16410–16418) |
(同 cache) |
| 显存 | 基线 | 基线 | + 3 张数据图(见注意事项) |
三、目录结构
ai-demos/vat-spine/
├── README.md                  # 本文
├── shaders/
│   └── vat-spine.effect       # 顶点阶段采样 VAT 的 effect(Cocos 3.8.x)
├── components/
│   └── VATSpine.ts            # 运行时组件:建静态网格 + 每帧只改 frameIndex
├── bake/
│   └── bake-vat.ts            # 离线烘焙脚本(复用 spine wasm,零依赖导出 PNG)
├── demo/
│   └── VATSpineDemo.ts        # 纯代码加载资源并跑起来的示例
└── demo2/                     # 社区仓库下载的「量产级」VAT 运行示例(Cocos 3.8.6)
    └── assets/resources/vat/  # VatBatchRenderer / VatMeshBuilder / VatBatchResourceCache / VatRuntimeTypes
四、快速体验
-
准备 Spine 资源:一个 Spine 导出(
.skel/.json+ atlas + 图),且所有 attachment 已合并进同一张 atlas 图(多 atlas 会让 VAT 装不下,见注意事项 ③)。 -
烘焙:在能访问引擎
spine模块的环境(Cocos 编辑器扩展 / 已加载 wasm 的 Node)里调用bake():
把这四个文件 + 合并后的 atlas 图,放进import { bake } from './bake/bake-vat'; const meta = bake({ skeletonData: mySkeletonData.getRuntimeData(), animationName: 'idle', fps: 30, outDir: './vat-output' }); // 产出 vat-pos.png / vat-uv.png / vat-color.png / vat.jsonassets/resources/vat/。 -
建材质:把
shaders/vat-spine.effect拖进工程(assets 下),基于它新建一个 Material(vat-spine.mtl),设好混合(见 effect 内注释)。 -
跑示例:把
demo/VATSpineDemo.ts挂到 Canvas 下的空节点,运行;或自己挂VATSpine组件并填好 4 张纹理 +vat.json+ 材质。
五、使用方式
运行时组件 VATSpine(属性面板)
| 属性 | 说明 |
|---|---|
meshRenderer |
本节点 MeshRenderer(缺省自动加) |
vatPos / vatUv / vatColor
|
三张数据图(RGBA8) |
atlasTex |
合并后的 Spine atlas |
material |
基于 vat-spine.effect 的材质 |
meta |
烘焙产物 vat.json(JsonAsset) |
bakeFps |
烘焙帧率(默认 30,应与 bake 一致) |
loop |
是否循环 |
interpolate |
是否双帧插值(见注意事项 ⑦) |
每帧逻辑(update)只做:_frame += dt * bakeFps; material.setProperty('frameIndex', floor(_frame))。无顶点上传、无骨骼解算。
烘焙 bake() 关键参数
-
fps:烘焙帧率。30Hz 烘焙 + 60Hz 渲染时需插值才顺(见 ⑦)。 -
useTint:双色 tint 时 stride=28,本 baker 仅取第一套色(第二套需再加一张图)。 - 自动校验:顶点数/拓扑逐帧一致;多 atlas 直接报错。
六、数据编码方案
三张图均为 RGBA8,宽=顶点数,高=帧数(行=帧,列=顶点):
| 纹理 | R | G | B | A |
|---|---|---|---|---|
vatPos |
posX hi | posX lo | posY hi | posY lo |
vatUv |
uvU hi | uvU lo | uvV hi | uvV lo |
vatColor |
r | g | b | a |
- 位置用 16-bit 量化相对包围盒:
norm = (v - boundsMin) / boundsSize; hi=floor(norm*65535/256); lo=norm*65535 & 0xff。 - 解码(shader 内
decode16):(ch.r*255*256 + ch.g*255) / 65535。 - 颜色直接存字节(顶点色本就是 0–255)。
为什么不用 RGBA16F:微信小游戏/老移动 GPU 对浮点纹理过滤与采样支持不稳,RGBA8 全平台可用,且本例只做 NEAREST 精确采样(不插值),精度足够。桌面 WebGL2 想简化可改 RGBA16F(effect 末尾有注释)。
七、注意事项(坑位,按顺序看)
- 精度台阶化(最重要):位置/UV 是 16-bit 量化。角色很大或动画跨度很大时,顶点会出现肉眼可见的"台阶"。对策:① 尽量小尺寸角色;② 拆多张图分块;③ 桌面端改 RGBA16F。
- 拓扑必须固定:如果动画里切换了"不同网格"的 attachment(顶点数/三角形变了),VAT 的 (列=顶点) 网格就错位。Baker 已加校验会直接报错。只切"同一网格不同纹理区域"的 attachment 通常 OK。
- atlas 必须合并:多个 atlas 页 → 多个 textureID → VAT 一张图装不下,也合不了批。烘焙前用纹理打包工具合并成一张图。
- "实时烘焙"有一次性卡顿:帖子说自己"实时烘焙"单个动画,那会在首帧跑一遍 wasm 解算全部帧——生产环境务必离线烤好随包发布,别运行时烤。
- 测试机不是真机:帖子数据来自 M4 Pro + Chrome 低端模拟,不是真实手机/微信。真机 GPU 行为、精度、Draw Call 上限都不同,上线前务必真机验证。
- 微信浮点纹理:如需 RGBA16F 简化路径,先确认目标微信基础库/机型支持;否则老老实实 RGBA8。
-
插值:30Hz 烘焙、60Hz 渲染会有动作卡顿。要做顺滑需 shader 同时采样相邻两帧并 mix(在 effect 里加
frameIndexNext+ 系数,VATSpine目前只演示单帧驱动)。 -
只适合被动动画:IK、运行时换 skin、动态挂点、动画混合(mix)在 cache 模式下本就不支持,VAT 同样不支持——这些仍走原生
sp.Skeleton。
八、性能预期(诚实版)
- vs REALTIME:大幅降低 CPU(去掉每帧 wasm 解算 + 顶点上传),方向同帖子,但别直接引用 6.9×。
- vs 官方 cache:CPU 再省"顶点 memcpy + 上传 + 顶点色打包"这一小段;最大价值是打通 GPU Instancing 合批(把 N 个角色压到 1 个 Draw Call)。单角色而言,VAT 相对官方 cache 的帧时间收益有限,别指望数量级差异。
- 显存:多 3 张数据图。尺寸 = 顶点数 × 帧数 × 4 字节 × 3 张。长动画 + 高顶点要算清楚(帖子 34.7KB 只是单短动画)。
九、源码证据链(本示例所依)
| 结论 | 证据 |
|---|---|
| 官方 cache 模式枚举 |
cocos/spine/skeleton.ts SpineAnimationCacheMode(REALTIME/SHARED_CACHE/PRIVATE_CACHE) |
| cache 模式运行时零解算 |
cocos/spine/skeleton.ts:1065-1095(_updateCache 只取 frames[frameIdx]);skeleton.ts:1151-1159(updateRenderData 返 _curFrame.model) |
| cache 仍每帧上传顶点 |
cocos/spine/assembler/simple.ts cacheTraverse(vUint8Buf.set(model.vData) + setDirty) |
| 烘焙接口可复用 |
cocos/spine/skeleton-cache.ts AnimationCache.updateToFrame(同款 SkeletonInstance wasm 路径) |
| 帧率 1/60 |
cocos/spine/skeleton-cache.ts:33 FrameTime = 1/60
|
| 顶点布局 24B |
cocos/2d/renderer/vertex-format.ts:80 vfmtPosUvColor4B(RGB32F+RG32F+RGBA8);颜色字节偏移 20 与 assembler 一致 |
| cache 禁 IK/换皮/挂点 |
cocos/spine/skeleton.ts warnID 16410–16418、1908 Cached mode can't change texture of slot
|
十、已知限制 / 下一步
- 单实例
VATSpine= 1 角色 1 Draw Call;1 Draw Call 跑 200 角色需 GPU Instancing(见demo/VATSpineDemo.ts末尾的合批说明,以及demo2的VatBatchRenderer量产实现)。 - 双色 tint 仅取第一套色;如需完整两色需再加一张图并在 shader 还原。
-
vat-spine.effect是按 3.8.x 语法写的参考实现,首次使用前请在编辑器内编译校验 built-in uniform 名(cc_matWorld/cc_matViewProj)。 - 真机(尤其微信小游戏)性能与精度需实测,不要直接采信桌面基准。
十一、何时才推荐采用本方案(采用决策树)
只在「官方 SHARED/PRIVATE CACHE 已经顶不住、且 VAT 的硬约束你能接受」这个组合下,才值得做。 单独满足其中一两条,多半是白折腾。
四条同时满足,才推荐尝试
- 同屏有「数百个」被动播放的 Spine:装饰、背景、杂兵 NPC 这类——在场但几乎不参与交互。几十个以内的话,官方 cache 的 Draw Call 与每帧顶点上传根本不是问题,别动。
-
瓶颈真的是 Draw Call / 每帧顶点上传,不是骨骼解算:官方 cache 模式运行时已经不做骨骼解算(
skeleton.ts:1065-1159只取缓存帧),最贵的 CPU 开销已被白送。VAT 能再啃的只是assembler/simple.ts里cacheTraverse每帧的vUint8Buf.set(model.vData) + 顶点色循环 + setDirty()这条顶点拷贝+上传残差,以及顺手打开 GPU 合批。瓶颈在别处(逻辑、其他来源的 Draw Call、贴图尺寸)时 VAT 救不了。 -
动画满足硬约束:
-
拓扑固定:顶点数、三角形逐帧一致(否则 attachment 换网格会撑破
(frame, vertexID)网格); -
能合进单张 atlas:多 atlas 页会自己多 Draw Call(
cacheTraverse按textureID请求 draw data),VAT 也合不了; -
无 IK / 无运行时换皮 / 无动态挂点:cache 模式本就禁这些(
skeleton.ts:1907warnID 16410–16418),VAT 同理; - 能离线烘焙出包:runtime 烘焙有一次性 wasm 卡顿,不能算进收益(见注意事项 ④);
- 接受 RGBA8 精度:坐标量化进 8 位,小物体 OK,大世界坐标会台阶化抖动(见注意事项 ①)。
-
拓扑固定:顶点数、三角形逐帧一致(否则 attachment 换网格会撑破
- 确实要把全场压到 1 个 Draw Call,或彻底去掉顶点上传:如果"省掉每帧顶点上传"就够了、不需要真·合批——那官方 cache 的性价比已经最高,没必要上 VAT 的复杂度。
决策树
同屏有数百个被动 Spine? ──No──> 几十个以内 → 官方 cache 就够
        │ Yes
        ▼
瓶颈是 Draw Call / 顶点上传? ──No──> 先治别处(逻辑/其他 DC/贴图)
        │ Yes
        ▼
动画满足硬约束(固定拓扑·单 atlas·无 IK·可离线·接受 RGBA8)?
        │ No ──> 用官方 SHARED/PRIVATE CACHE(已免骨骼解算,性价比最高)
        ▼ Yes
   只省上传够吗? ──够──> 官方 cache 已够,不必上 VAT
        │ 真要 1 Draw Call 合批
        ▼
   尝试 VAT ✅(零顶点上传 + 真 GPU 合批)
判定基准必须是「官方 cache vs VAT」,而不是帖子里的「REALTIME vs VAT」——后者把官方 cache 已白送的骨骼解算收益也算进了 VAT 头上。
反例:这些情况别碰 VAT
-
主角 / 需要交互的 Spine(IK、换皮、动态挂点)→ 走原生
sp.Skeleton。 - 动画间会切换不同顶点数的 mesh attachment → VAT 固定网格会爆,得烘 max-vertex 缓冲或分子网格,成本骤增。
- 拓扑 / atlas 无法统一 → 用官方 cache 也比硬改 VAT 稳。
- 只想拿到帖子那个 6.9× 数字 → 那是 vs REALTIME 的,对你实际项目的 cache→VAT 增量远没那么大(见第八节「性能预期」)。
一句话:VAT 是「大量被动 Spine + 卡在 Draw Call/上传 + 能接受固定拓扑单 atlas 离线烘焙」这一窄窗口里的正确武器;窗口外的,先用官方 cache 就好。
十二、demo2:量产级参考实现带来的增量知识
demo2/ 是社区仓库(Cocos 3.8.6,spineboy-pro)抽离出的业务级运行示例,默认压测 2000 实例。它把上面的示例只当概念验证的位置全部补齐,也暴露了几个原示例没踩到的坑。除非你要把它接进真实项目,否则不必照抄其代码——但下面几条是它验证过、且值得在新项目里直接用上的知识。
1. GPU Instancing 真正落地(这才是 1 Draw Call 的正确做法)
原示例只写了"下一步要合批"。demo2 的 VatBatchRenderer 是靠 轻量 MeshRenderer 子节点 + 共享 Mesh/Material + 实例化属性完成的:
- 每个实例 = 一个
Node+MeshRenderer,位置/缩放走子节点世界矩阵; - 所有实例 共享同一份 Mesh 和父 Material,Cocos 3.8 的实例化队列按「相同 Mesh、材质、Shader 变体」自动合并 Draw Call,开发者不需要手写
setInstancedBuffers/InstancedBuffer; - 按实例参数走
renderer.setInstancedAttribute('a_jointAnimInfo', [timeBase+offset, frameStart, fps, duration]);#if USE_INSTANCING用CCGetWorldMatrix(matWorld)还原世界矩阵; - 设备不支持
INSTANCED_ARRAYS特性时自动回退:setSharedMaterial(materialParent)+ 每个实例recompileShaders独立材质实例(getMaterialInstance),Draw Call 变多但正确。
2. 动画时间轴也搬到 GPU(不是每帧改 uniform)
原示例每帧 setProperty('frameIndex', ...),CPU 仍要逐实例推进。demo2 更进一步——每实例的播放也不再碰 CPU 逐帧:
- 共享一个全局时钟
vatGlobalTime(game.totalTime/1000); - 每个实例在
a_jointAnimInfo里打包(timeBase + 1000000 偏移, frameStart, fps, duration/loop);duration 正负号作为 loop 标志; - 顶点着色器里
rawTime = globalTime - (timeBase),再mod(循环)或min(非循环)算出当前帧; - CPU 端只在状态真变了(play/pause/seek/换动画/变速/离屏恢复)时把该实例
needsUpload打标,每帧按一张Set批量flushScheduledInstanceUploads,平时是零 per-instance 更新。
好处:动画播放与 CPU 帧率解耦,且把 2000 个实例的每帧推进成本压到接近 0。
3. 三张数据图 → 一张「网格布局」数据图 + 版本兼容
原示例是 3 张独立 RGBA8(pos/uv/color)。demo2 将位置 X、位置 Y、顶点色三组数据揉进同一张 vat-data.png,靠 layout.rowsPerFrame 组织:
-
VatRuntimeTypes.ts里vat.json只写rowsPerFrame=3、positionXRowStart / positionYRowStart / colorRowStart与columns、vertexRows; - 顶点按「grid-by-vertex-id」跨行列布局:
vertexRow = floor(vertexId / columns),同一帧 3 行分别放 XY 和颜色;每帧占rowsPerFrame行; - 只省了显存里两张数据图;换代价是
vat.json要声明 layout 且 Shader 按它做行列换算; - 配套给出了 格式版本兼容解析(v2→v8:单动画 vs
animations[]、packed-xy-rgba 打包 vs split-xy-rg 分离、非法布局直接判null),生产环境换烘焙工具链时这是防呆的关键。
4. 顶点 ID 写进内置 a_position.x,而不是只挂自定义属性
VatMeshBuilder.ts 的实测结论:微信真机部分图形后端对「单浮点自定义属性」的绑定不稳定。所以它把 VAT 顶点 ID 同时写进内置 position.x(positions[i*3] = vertexIds[i]),Shader 用 a_position.x 当 vatVertexId;自定义 a_vatId(R32F) 只是保留。位置、UV 的真实几何交给 VAT 解码,position 只剩占位——这与原示例用 uv.x 当顶点列的思路殊途同归,但更贴近真机兼容性。
5. 多动画并存同一张 VAT 纹理
vat.json 的 animations[] 为每个动画记录 frameStart/frameCount(同一张纹理里按帧区间分段存放),运行时每个实例可独立选动画,Shader 按 frameStart + localFrame 采样。原示例只支持「单动画」。
6. DrawOrder 变体:遮挡顺序变化的动画要预烘焙多份索引
Spine 动画里 slot 前后遮挡关系会随时间变,demo2 用「DrawOrder 变体」解决:
- 烘焙时把固定拓扑按 slot 顺序重排成多份三角索引(
IVatDrawOrderVariant),动画时间→变体 ID 的映射写在drawOrderKeys; - 运行时到时间点就
renderer.mesh = drawOrderMesh(variantId)切网格; -
实测坑(重要):Cocos 3.8 的实例化队列会缓存前一份 Mesh 的 InputAssembler,切 DrawOrder 变体的索引时,必须
enabled=false → setMesh(newMesh) → enabled=true重刷实例属性,否则会把新顶点配到前一份索引上报错/错乱(见VatBatchRenderer.refreshInstanceDrawOrderVariant注释)。
7. 帧插值与 LOD 帧步长真正写成 Shader
原示例的 interpolate 是占位。demo2 在 VatBatch.effect 里做了两件事:
-
VAT_INTERPOLATE_FRAMES:同时采样localFrame和localFrame+1(循环动画在末尾 wrap 回 0),按fract(sampledTime)mix 两帧位置; -
vatFrameStep(LOD):采样前floor(sampledTime/step)*step隔帧采样,只降帧密度、不改播放速度,适合远处/小尺寸实例。
8. 大数量下的工程化组件
2000 实例压测级场景里这些都不可或缺,原示例没有:
-
Camera 可见性剔除:离屏实例只
renderer.enabled=false(不销毁、恢复时续播),带visibilityPadding边距与visibilityCheckInterval间隔控制 CPU 成本; -
实例对象池:
maxPooledInstances复用节点,避免增删实例反复 mall和创建 Node/渲染器; -
跨组件 Mesh/Material 引用计数缓存:
VatBatchResourceCache(acquire/release),Key 含meshAsset.uuid + positionRange与「材质+纹理+元数据+instancing+alphaMode+pma/layout+插值」等,分享同一份资源。
9. 其它细节
-
alphaMode='straight' | 'pma':pma(预乘 alpha)时 Fragment 阶段/max(color.a, ...)还原,并discard掉alpha<=0.001的顶点收敛透明像素覆盖成本; - 数据纹理必须
NEAREST + mip=NONE + CLAMP_TO_EDGE(configureVatTexture),防止相邻顶点列/帧行互相污染——原示例在 README 注意事项 ⑥ 提过同类点; - 由于它只带运行时、不带烘焙工具,其
vat.json/.mesh.json/单张vat-data.png的资源约定可作为原示例 bake 输出的可选升级方向(把 3 张图合并成 1 张、补齐animations[]多动画、加 drawOrder 变体)。
补充对比小结:原示例 =(3 张数据图 · 单动画 · 每帧一个 uniform · 单实例 1 DC)的概念验证;
demo2=(1 张网格数据图 · 多动画 · 时间轴跑 GPU · GPU Instancing 1 DC 跑 2000 实例 · 剔除/对象池/缓存)的生产参考实现。两者针对的是同一个技术,只是 demo2 补上了「量产」这一层。真要把某个场景接进项目时,优先以 demo2 的资源约定与 Shader 为准。
1赞
官方 SHARED/PRIVATE CACHE
IK / 动态换 skin / socket
这个错了
官方CACHE,IK可能不行,但socket和换装是可以的
实际我最开始的版本没有用GPU Instancing 也可以一个drawcall 只要IA提供的数据够多