基于 Cocos Creator 2.4.12,Web 平台。
一、背景
Web 端如果同屏需要显示上千只 Spine 怪物,叠加 Zindex 排序,对于DrawCall 来说可以说是灾难了。
我之前做过一次图片多纹理合批的尝试,性能优化5-MutilTexture地图物件多图渲染合批 其实当时就有在想,Spine 能不能也用一样的操作优一下呢?(最近又想起这件事来了,折腾一下。
二、思路
怪物Spine导致合批打断最常见的就是使用的图片发生了切换,导致引擎计算出材质实例的哈希值不同。那如果我们能够让所有的怪物使用相同的材质,这个问题不就解决了吗?
如果我们不合并贴图(要也行,但没必要一来就上最高难度是吧),只是:
- 所有怪物共用一个材质,这个材质同时绑定多张纹理;
- 在 Shader 中选择不同的纹理,进行采样。
哎好像有点靠谱了嗷。
怎么实现纹理的选择呢?这次又想到一个骚操作,在Sprite 合批里面,年轻的我还只会增加顶点数据的字段,但今日之我已非昨日之我!
UV 数据中的 U,表示顶点对应图片中的采样点位置(X,Y),一般是一个[0, 1]的数字,但其实,它是一个 float32 对象,这也就意味着,它可以是 0.5,也可以是 1.5、更可以是 2.5!
既然有这个本事就别浪费了,这样:
如果你是[0,1],那你就是第一张图片,数值还是表示图片中对应的位置
如果你是[2,3],那你就是第二张图片,但是采用计算的时候数字要-2
…
这不就既要又要了!毕竟在 Spine 这种复杂内容下,多一个顶点数据,也是一笔不小的开销。
(题外话:既然X能够复用,那是不是Y也…)
不过到这里其实和Sprite没什么太大区别。Spine的重点是Attachment,它们分别表示了每一个我们能够看到的部件(手、头、武器…),所以其实Spine的本质也是一堆图片。
所以我们要做的就是把同一个材质挂到所有Attachment上!
三、实现
1. 多纹理 Shader:按 UV 选择采样器
文件:monster-spine.effect
UV 编码规则:u' = u + 2 × 槽位下标。这样各槽位的 u.x 就会落在互不重叠的区间里:
| 槽位 | 0 | 1 | 2 | … | 7 |
|---|---|---|---|---|---|
| u.x 区间 | [0, 1] | [2, 3] | [4, 5] | … | [14, 15] |
顶点着色器解出槽位下标,并还原原始 UV:
// 加 0.5 再 /2 取整
float slot = floor((a_uv0.x + 0.5) * 0.5);
v_slot = slot;
v_uv0 = vec2(a_uv0.x - slot * 2.0, a_uv0.y);
片元着色器按槽位下标选择采样器:
// GLSL ES 1.0 不支持用变量下标访问数组,只能分支选择,做个二分小优化
vec4 sampleSlot (float slot, vec2 uv) {
  if (slot < 3.5) {
    if (slot < 1.5) {
      if (slot < 0.5) return texture2D(texture, uv);
      return texture2D(texture1, uv);
    }
    if (slot < 2.5) return texture2D(texture2, uv);
    return texture2D(texture3, uv);
  }
  // ... 槽位 4 ~ 7 同理
}
3. 改写 Spine 数据:UV 偏移 + 纹理
文件:SlotSkinPatcher.ts
对所有怪物的 SkeletonData,遍历它的所有 atlas 区域:
export function patchToSlot(data: sp.SkeletonData, slot: number, texture: cc.Texture2D): void {

    const skelTex = new sp.SkeletonTexture({ width: own.width, height: own.height });
    skelTex.setRealTexture(texture);

    atlasRegions(data).forEach((region) => {
        region.u += slot * 2;       // UV 加上偏移值
        region.u2 += slot * 2;
        region.texture = skelTex;   // 统一换成第一张图片
    });
    refreshAttachmentUVs(data);     // 附件在创建时已算好 UV,需要重新计算
}
重点:
-
纹理必须是槽位 0 的贴图。 引擎取材质时会把
texture属性覆盖成区域的纹理。如果槽位 0 放的是别的贴图,就会被覆盖掉。统一设置也能保证哈希值的计算结果。 -
使用
SHARED_CACHE时要作废旧缓存。 动画缓存是按旧 UV 烘焙的,改完 UV 后需要调用invalidAnimationCache()重新烘焙。
4. 共享材质:一次绑定 8 张纹理
文件:SlotMaterial.ts
const SLOT_COUNT = 8;

constructor(effect: cc.EffectAsset, textures: cc.Texture2D[]) {
    for (let i = 0; i < SLOT_COUNT; i++) {
        this._textures[i] = textures[i] || textures[0];   // 空槽位用第一张图占位
    }
    this._material = cc.Material.create(effect);
}

/** 应用纹理到材质变体上,保证图集顺序一致,哈希值也会一致 */
apply(skeleton: sp.Skeleton): void {
    const variant = skeleton.setMaterial(0, this._material);
    for (let i = 0; i < SLOT_COUNT; i++) {
        variant.setProperty(i === 0 ? "texture" : "texture" + i, this._textures[i]);
    }
}
5. 骨骼接入
文件:MinBatchTest.ts
const skeleton = node.addComponent(sp.Skeleton);
skeleton.enableBatch = true;          // 开启合批
skeleton.setAnimationCacheMode(sp.Skeleton.AnimationCacheMode.SHARED_CACHE);
material.apply(skeleton);             // 使用共享多纹理材质
skeleton.skeletonData = data;         // data 需已经过 patchToSlot 处理
整体流程:
- 预加载怪物的Spine资源;
- 取每种怪物的贴图,按顺序放入槽位,创建共享材质;
- 对每种怪物的 SkeletonData 执行
patchToSlot; - 生成怪物时套用共享材质。
四、效果
测试条件:3000 只怪、5 种贴图(伪)随机混排、54万 顶点。小米15Pro,在运行5秒后开始统计FPS均值,并等待均值相对稳定后记录。
| 共享材质关 | 共享材质开 | |
|---|---|---|
| 材质种类 | 5 | 1 |
| DrawCall | 2417 | 16 |
| 平均FPS | 25.7 | 33 |
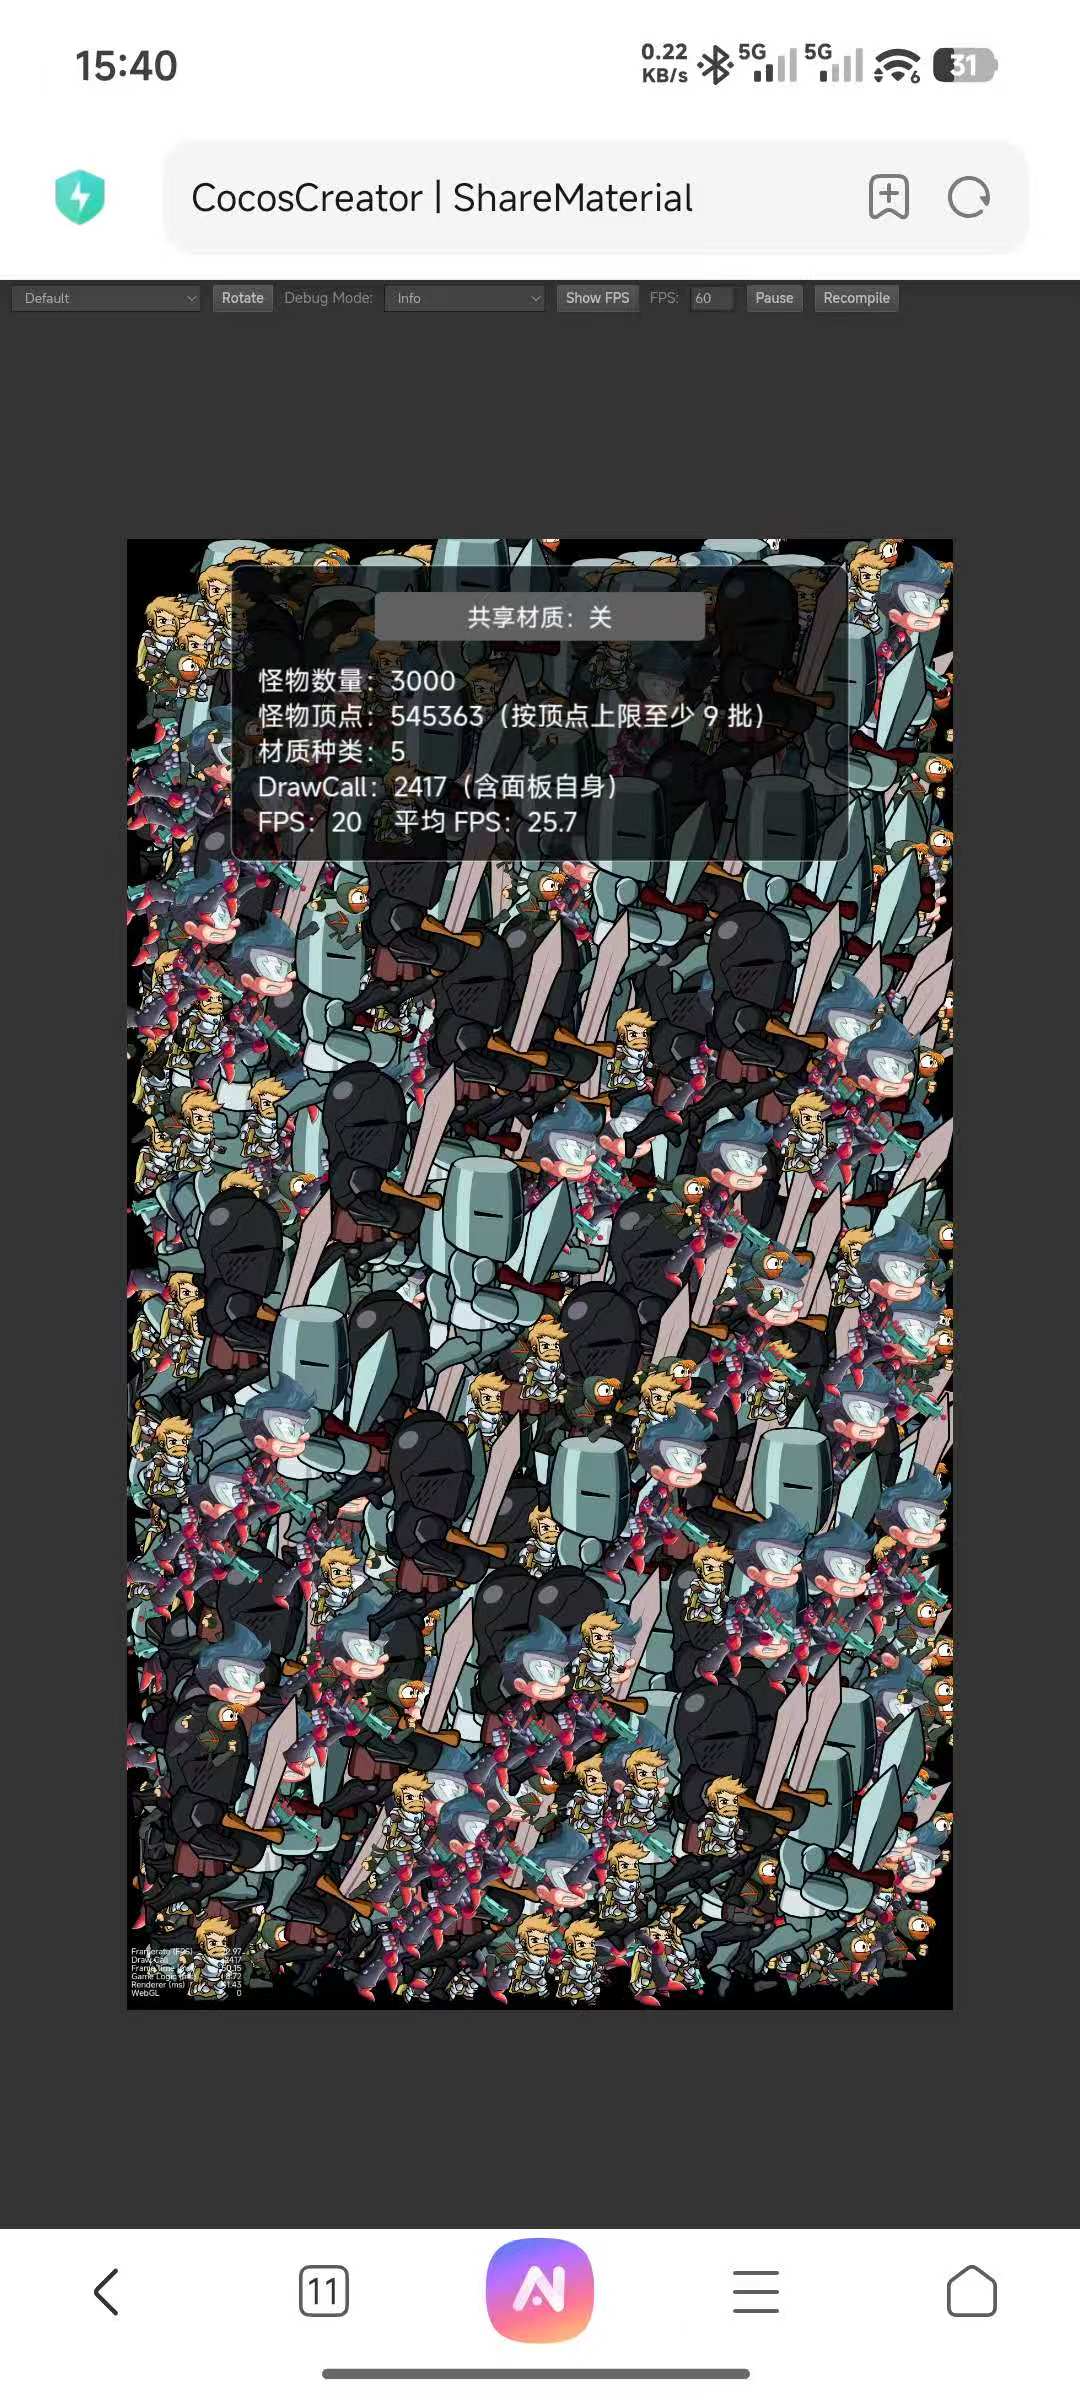
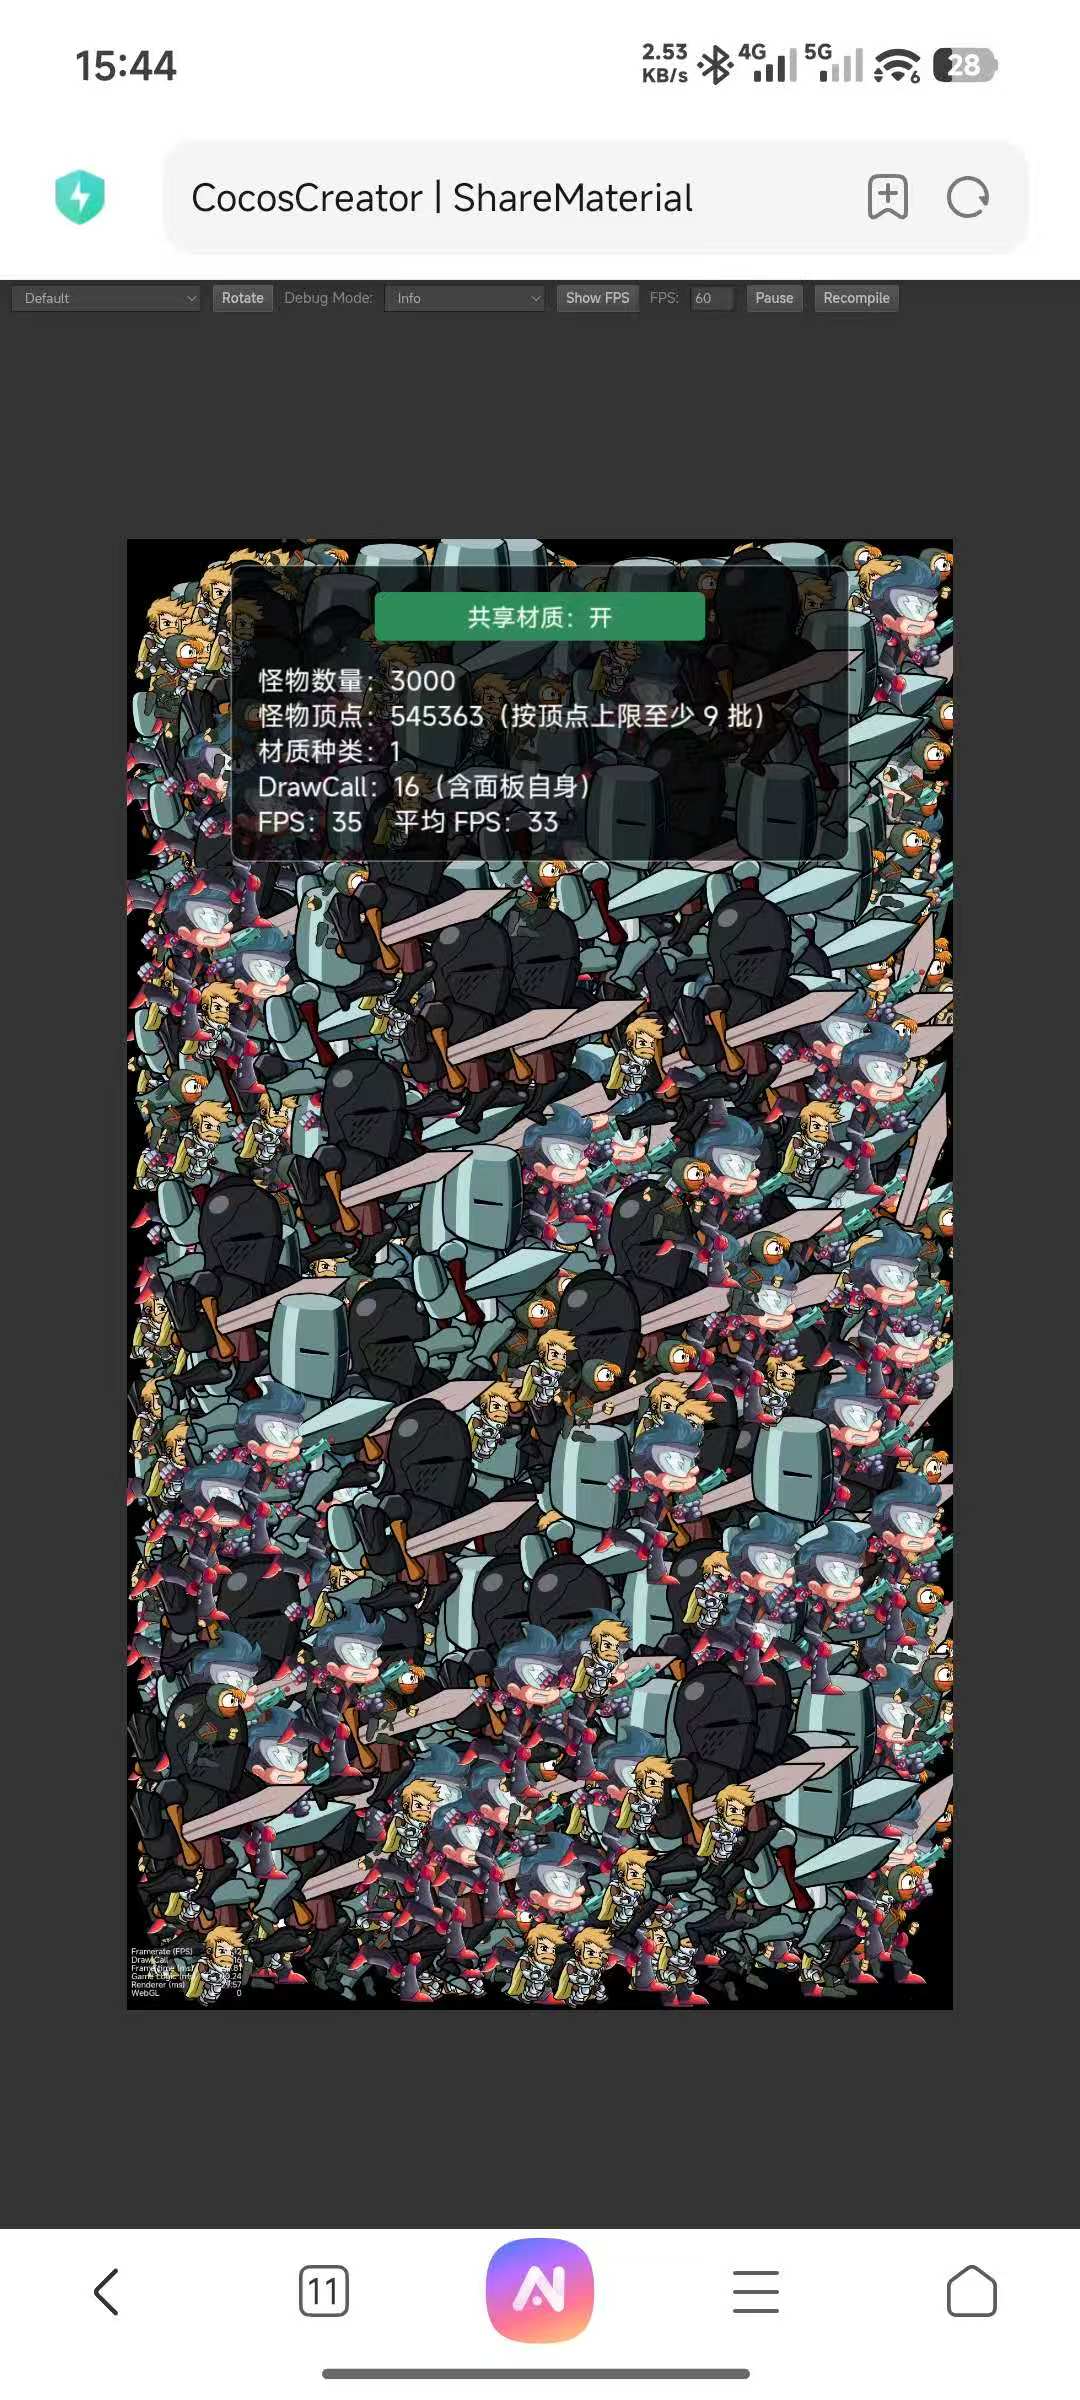
开启后的 16 次 DrawCall 中,怪物占 9 次,剩下的是面板和调试信息。
按照预期,怪物应该可以完全合批,最后剩下1次DrawCal才对,为什么呢?
这里还有一个限制:每个批次的最多只能包含 65535 个顶点,所以如果你使用含有了较复杂的 Spine(一个Spine有大量顶点),或者数量过多,就会容易出现合批后DrawCall > 1的情况。
五、一些其他内容
实话说做完验证后,效果并没有我想象中那么巨大,最开始在PC上测试,甚至效果比手机还小。
后来想通了:DrawCall 的优化本质上只是减少了多次提交导致的一些额外损耗,但是并不能解决顶点数量多等本质问题。
然后以下是一些拓展内容:
- 单材质建议 8 张纹理, WebGL1 保证片元着色器至少有 8 个纹理单元。
- 怪物种类超过 8 种,可以在运行时把多张贴图合进同一张图集页,再把图集页放进槽位,甚至实现动态合图。但因为贴图变化,会需要重新处理缓存,也会有额外的开销。
- 片元着色器多了分支采样,有少量额外的 GPU 开销,具体的效果可能因设备不同。
- 方案只减少了 DrawCall,顶点数和 CPU 每帧填充顶点的开销不变,不能期望DC优化带来巨幅提升。或许降低 Spine 的复杂度和图片数量也是一个不错的优化手段(2D减面数?)。